

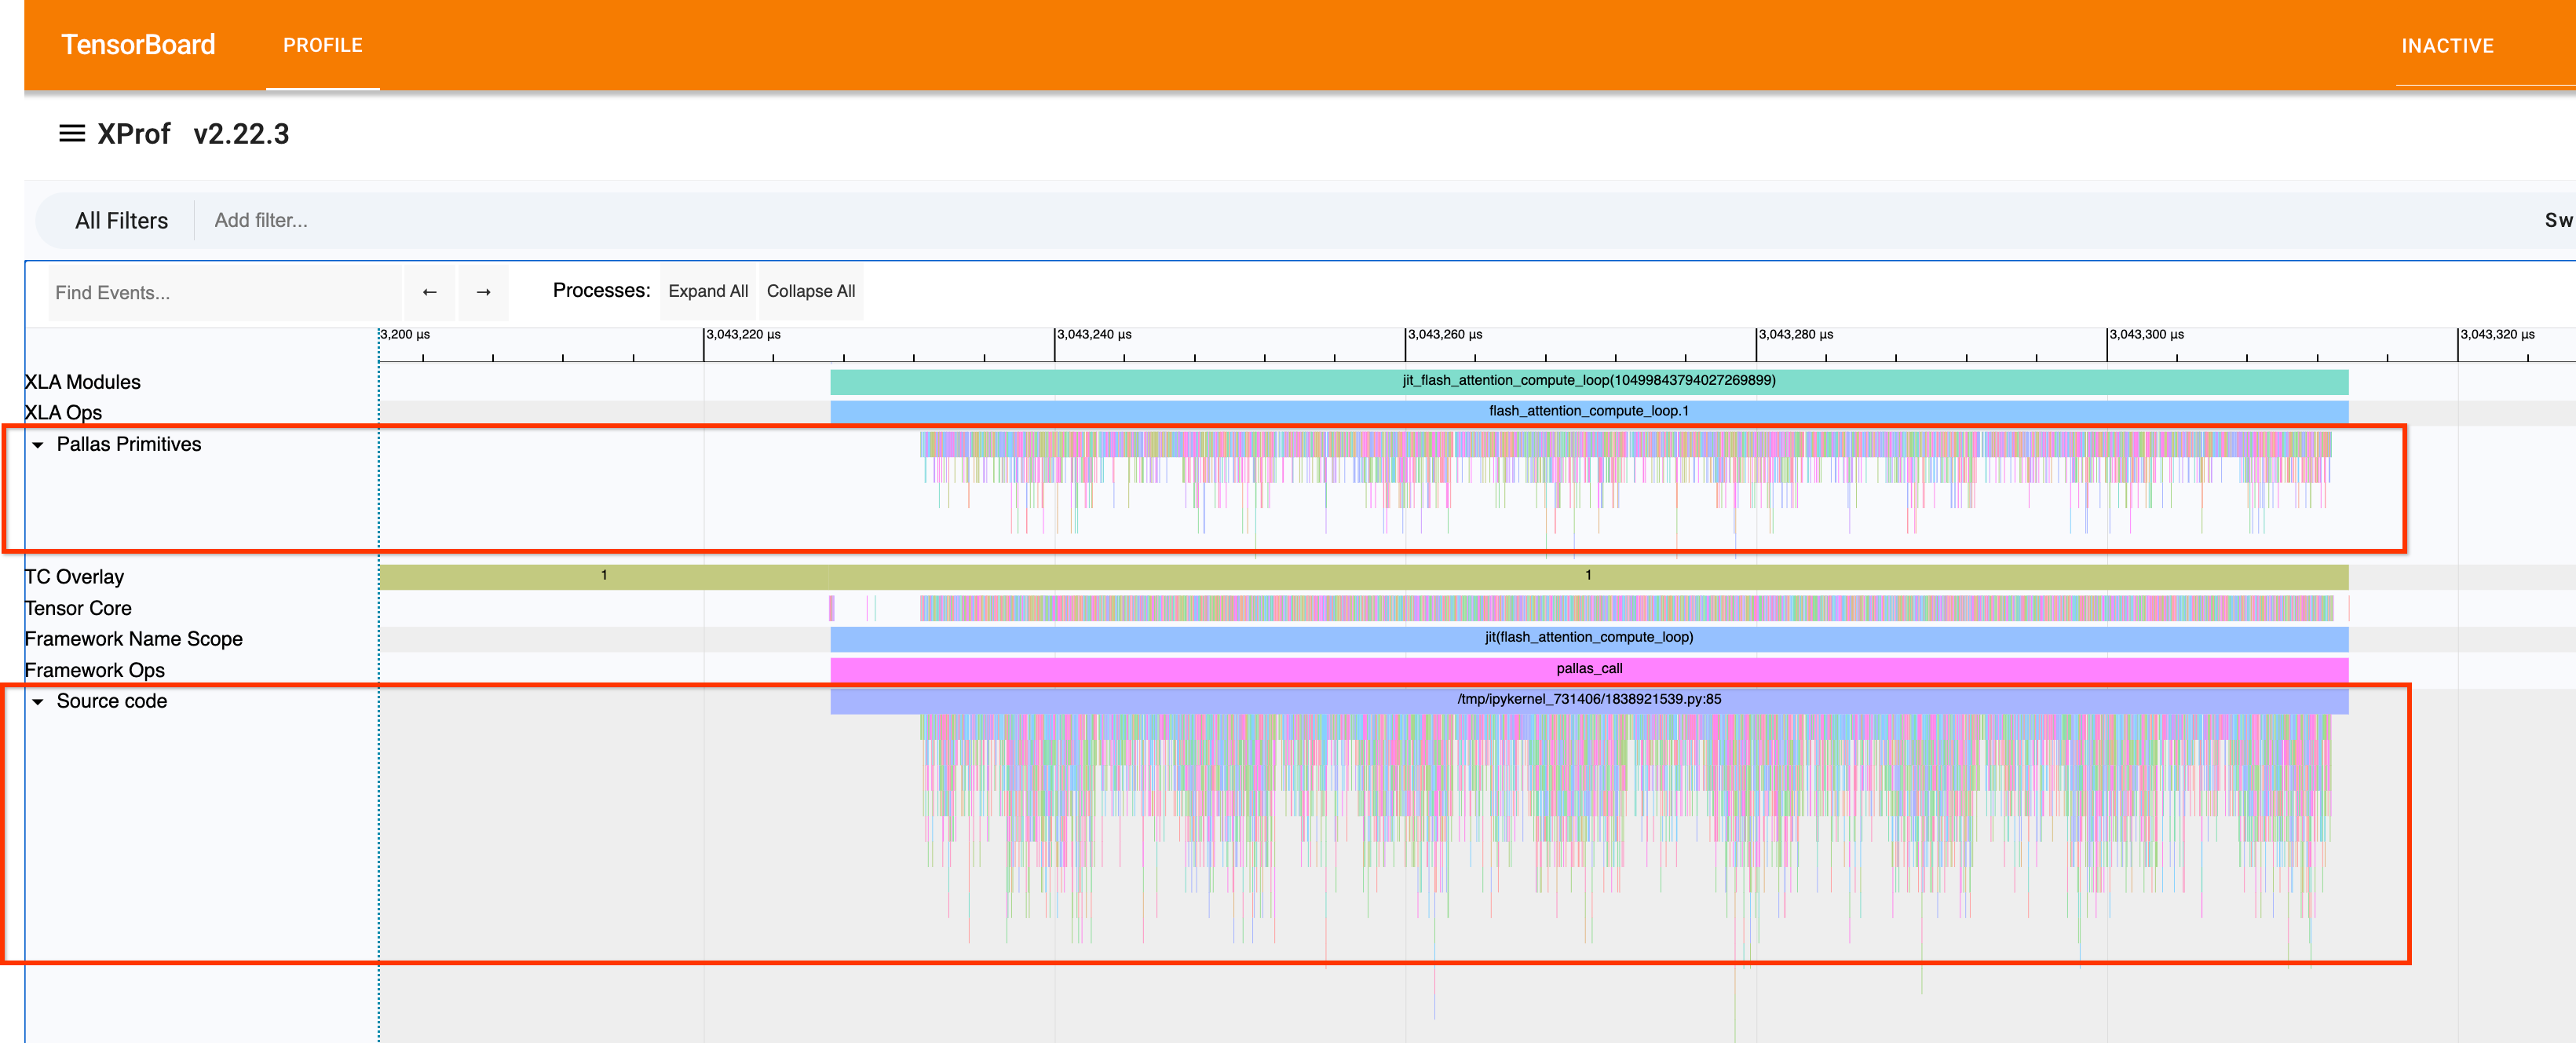
Пользовательские вызовы XLA позволяют выполнять пользовательские ядра или операции, которые изначально не поддерживаются XLA. Чтобы получить представление о производительности этих пользовательских вызовов в средстве просмотра трассировки , можно использовать специальные флаги XLA для включения подробной трассировки и отладочной информации LLO (низкоуровневого оптимизатора).
⚠️ ЭКСПЕРИМЕНТАЛЬНАЯ ФУНКЦИЯ : Анализ с помощью низкоуровневого оптимизатора (LLO) и пользовательское профилирование вызовов являются экспериментальными . Для доступа к этим функциям и всем инструментам анализа CLI (
get_kernel_stats,get_llo_analysis,get_llo_debug_string) установитеxprof-nightly. В стандартной версииxprofPyPI (2.23.1) эти подкоманды отсутствуют.
Предварительные условия и требования к набору инструментов
Перед началом записи трассировки LLO убедитесь, что ваша среда соответствует следующим требованиям:
- Python 3.11+ (рекомендуется Python 3.12) : Образы виртуальных машин Cloud TPU по умолчанию (Ubuntu 22.04) поставляются с системным Python 3.10.12, который незаметно ограничивает версию JAX до 0.6.2 и использует
libtpu0.0.17. В более старых сборкахlibtpuотсутствуют определения флагов LLO, что приводит кERROR: Unknown command line flagили возвращает пустые профили LLO. Настоятельно рекомендуется использоватьuvдля управления виртуальной средой Python 3.12. Установка пакета (
xprof-nightly) : Установитеxprof-nightlyвместе сjax[tpu]:# 1. Setup Python 3.12 environment pip install uv uv python install 3.12 uv venv --python 3.12 ~/venvs/v312 # 2. Install xprof-nightly and JAX uv pip install --python ~/venvs/v312/bin/python \ 'jax[tpu]>=0.11.0' xprof-nightly numpy ml_dtypes absl-py fireJAX >= 0.11.0 : Рекомендуемая версия набора инструментов (
libtpu >= 0.0.44). Обратите внимание, что отладочная информация LLO во время компиляции (--xla_xprof_register_llo_debug_info=true) поддерживается начиная сjax >= 0.10.2(libtpu >= 0.0.42), в то время как для включения трассировки пользовательских вызовов во время выполнения (--xla_xprof_enable_custom_call_tracing=true) требуетсяjax >= 0.11.0(libtpu >= 0.0.44).Строгий порядок переменных окружения :
LIBTPU_INIT_ARGSдолжен быть экспортирован в оболочке или настроен вos.environстрого доimport jax.libtpuанализирует флаги инициализации при самом первом импорте JAX; их установка послеimport jaxмолча не имеет эффекта и может вызвать исключение.
Матрица совместимости оборудования
| Возможности | Требования к оборудованию | Примечания |
|---|---|---|
Анализ и декомпиляция LLO ( get_llo_analysis , get_llo_debug_string ) | Любой поддерживаемый TPU (v6e, v5e, v4 и т. д.) | Полная поддержка на TPU v6e и v5e ( libtpu >= 0.0.42 ); поддержка не ограничена версией v7x. |
Настройка трассировки вызовов ( --xla_xprof_enable_custom_call_tracing=true ) | Любой поддерживаемый TPU ( libtpu >= 0.0.44 / jax >= 0.11.0 ) | Захватывает подробные данные трассировки LLO во время выполнения (увеличивает размер трассировки; частоту vtrace можно настроить через раздел «Как настроить» , если события прерываются). Отсутствует в libtpu 0.0.42 ( jax 0.10.2 ), где его установка приводит к прерыванию работы бэкенда. |
Периодические счетчики времени выполнения ( tpu_enable_periodic_counter_sampling ) | Ironwood TPU7x+ только | Для работы аппаратных счетчиков производительности требуется TPU v7x+. |
Диагностика доступности флагов
Чтобы убедиться, что установленный вами исполняемый файл libtpu содержит необходимые определения флагов перед запуском рабочих нагрузок, выполните следующий диагностический фрагмент:
import glob
import os
import libtpu

so_paths = glob.glob(os.path.dirname(libtpu.__file__) + "/*libtpu*.so")
if so_paths:
  blob = open(so_paths[0], "rb").read()
  for flag in (
      b"xla_xprof_register_llo_debug_info",
      b"xla_xprof_enable_custom_call_tracing",
      b"tpu_enable_periodic_counter_sampling",
  ):
    print(flag.decode(), "PRESENT" if flag in blob else "ABSENT")
Как включить трассировку
Рекомендуемый вариант по умолчанию: только отладочная информация LLO.
Для статического анализа LLO и профилирования на уровне HLO/ядра зарегистрируйте отладочную информацию LLO с помощью --xla_xprof_register_llo_debug_info=true . Это сохранит полный поток операций HLO в неизменном виде, так что get_hlo_stats , get_roofline_model , get_top_hlo_ops и get_kernel_stats будут работать без дополнительных накладных расходов на трассировку во время выполнения, при этом создавая полную карту исходного кода LLO, используемую функциями get_llo_analysis и get_llo_debug_string .
import os

# Flags MUST precede any jax / libtpu import
os.environ["LIBTPU_INIT_ARGS"] = "--xla_xprof_register_llo_debug_info=true"

import jax
# Workload definition and tracing...
-
--xla_xprof_register_llo_debug_info=true: Регистрирует отладочную информацию LLO, коды операций и метаданные для визуализации XProf.
Детальная трассировка пакетов LLO во время выполнения
-
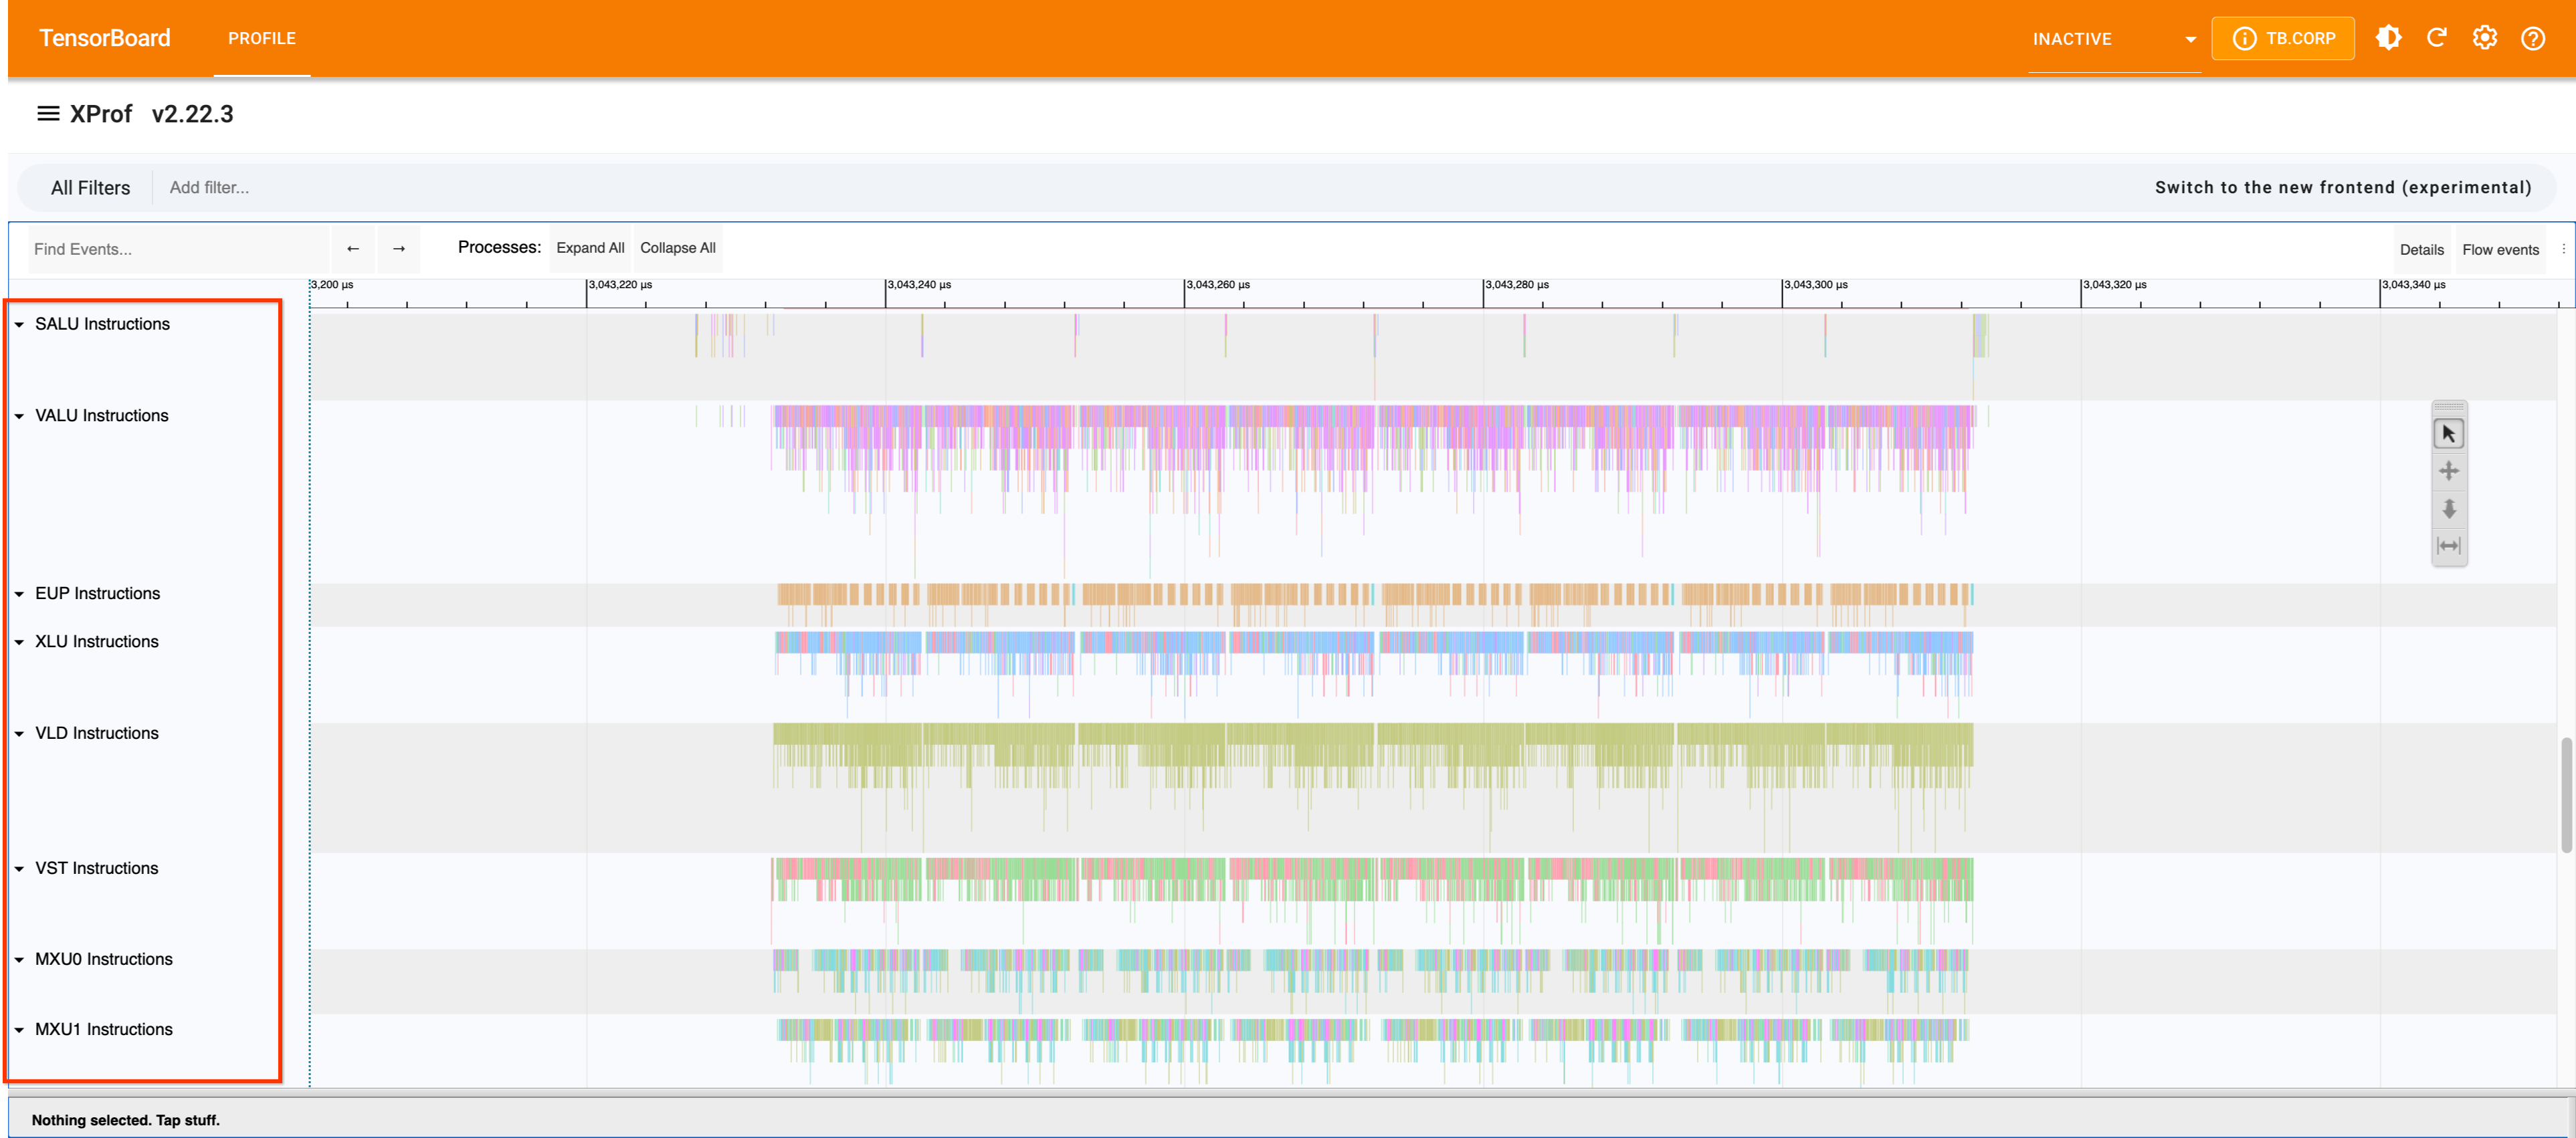
--xla_xprof_enable_custom_call_tracing=true: Канонический флаг, который включает детальную информацию о выполнении LLO во время выполнения (Pallas Primitives,LLO Opsи линии инструкций для каждого модуля в Trace Viewer) и автоматически активирует инструментарий пакета инструкций (xla_tpu_bundle_instrumentation_optionsсо значениями по умолчаниюtrace_best_effort_frequency=10иtrace_guaranteed_frequency=10).
| Pallas FlashAttention (10 итер, 8×4096×128 bf16) | --xla_xprof_register_llo_debug_info=true only | Оба флага ( + --xla_xprof_enable_custom_call_tracing=true , частота по умолчанию=10) |
|---|---|---|
| Размер трассировки TPU v6e-1 | 19,8 МБ | 127 МБ (6,4×) |
TPU v6e-1 get_llo_analysis (static) | 10 модулей, 103 224 инструкции (0,6 с) | Идентичные (2,7 с) |
TPU v6e-1 get_hlo_stats / get_top_hlo_ops | flash_attention.1 , 10×, 28.4 мс | NO_DATA / only IDLE |
TPU v6e-1 get_kernel_stats | flash_attention.1 , 28,363 мкс | Пользовательский вызов отброшен; только barrier-cores (25 672 мкс) |
| Размер трассировки TPU v7x (2×2×1) | 115 МБ | 1,42 ГБ (12,3×) |
TPU v7x get_llo_analysis (static) | 10 модулей, 103 239 инструкций (1,9 с) | Идентичные (33,6 с) |
TPU v7x get_kernel_stats | flash_attention.1 , 29,725 мкс (1,3 с) | flash_attention.1 , 27,098 мкс (−8,8%, 19,0 с) |
При использовании --xla_xprof_enable_custom_call_tracing=true настройте частоту трассировки виртуальных машин ( trace_best_effort_frequency и trace_guaranteed_frequency в xla_tpu_bundle_instrumentation_options ; см. раздел «Как настроить» ниже), если увеличенный размер трассировки приводит к переполнению аппаратного буфера трассировки.
Пример средства просмотра трассировки
Вот пример того, как выглядят трассировки LLO в программе просмотра трассировок Xprof:
Расширенные параметры (Обработка пропущенных событий)
Если в Xprof вы видите пропуски событий или переполнение буфера, это означает, что точки трассировки запускаются слишком часто, перегружая буферы трассировки оборудования. Вы можете настроить частоту вставки трассировки LLO с помощью расширенных параметров.
Эти параметры настраиваются через xla_tpu_bundle_instrumentation_options . Вы можете контролировать, как часто трассировки упаковываются в пакеты инструкций.
Ключевые параметры
-
trace_best_effort_frequency(По умолчанию: 10): Целевой интервал (в пакетах) для вставки трассировок, упакованных в существующие пакеты. Компилятор будет пытаться вставить трассировку с такой частотой, но не будет создавать для нее новые пакеты. -
trace_guaranteed_frequency(По умолчанию: 10): Максимальное количество пакетов, разрешенных между двумя трассировками. Это гарантированное значение. Если мы не можем обеспечить это значение путем упаковки трассировок в существующие пакеты, мы создадим новый пакет и поместим трассировку туда (отдельно).
Как настроить
- Если вы видите сообщение "Пропуск событий" : увеличьте значения (например, установите значение 50 или 100), чтобы трассировка выполнялась реже , что уменьшит объем генерируемых данных трассировки.
- Если вам нужна более высокая детализация : уменьшите количество значений, которые необходимо отслеживать чаще (ценой увеличения накладных расходов и потенциального переполнения буфера).
Как рассчитывается количество циклов выполнения инструкций
Поскольку точки трассировки вводятся выборочно, а не при каждой отдельной инструкции, промежуточные временные метки интерполируются на основе оценочных затрат на аппаратные циклы.
Компилятор вычисляет внутреннюю стоимость аппаратных циклов каждой инструкции LLO на основе целевого поколения TPU и исполнительного блока, который её обрабатывает. Эти значения количества циклов представляют собой пропускную способность выполнения и задержки.
Поток высокого уровня
- Инструкция по разбору LLO : Определите код операции и метаданные.
- Получение базовых аппаратных циклов : определение циклов на основе поколения TPU (v5e/v5p, v6e/v7x и т. д.).
- Преобразование в такты глобального счетчика таймера (GTC) : Преобразуйте циклы в такты глобального счетчика таймера (GTC), используя формулу:
Cycles * (GTC_Freq * 16) / TC_Freq. - Создать временной интервал : равномерно интерполировать промежуточные события между известными границами трассировки.
Расчеты циклов по энергоблокам и источникам генерации
Ниже приведены примеры моделирования базовых аппаратных циклов для различных исполнительных блоков:
Блок матричного умножения (MXU)
Показатель количества циклов MXU отражает пропускную способность в зависимости от плотности типов данных.
| Категория инструкций | Подтип / Формат | (v5e/v5p) | (v6e/v7x) |
|---|---|---|---|
| Вектор Матмул | Ф32 | 8 | 8 |
| Предварительная обработка матричных уравнений (F8 до BF16) | 4 | 4 | |
| Упакованный BF16 | 2 | 2 | |
| Целочисленные форматы (U8, S8, U4, S4) | 1 | 1 | |
| Векторные защелки | Транспонированный F32 | 4 | 4 |
| Транспонированный BF16 | 8 | 8 | |
| Нетранспонированный F32 | 2 | 2 | |
| Нетранспонированный BF16 | 4 | 4 | |
| Matprep / Dwg | Все | 1 | 1 |
Транспонированный блок (XLU)
Количество циклов отражает задержки транспонирования в памяти и задержки кроссбара.
| Категория инструкций | Подтип / Формат | (v5e/v5p) | (v6e/v7x) |
|---|---|---|---|
| Упакованный транспон | Все | 17 | 4 |
| Стандартный транспонирование | B32 Транспонирование | 9 | 4 |
| B16 Транспонирование (сегментированное/сжатое) | 17 | 4 |
Пул исполнительных блоков (EUP)
Инструкции EUP представляют собой векторные математические функции (например, tanh , log , exp ).
| Категория инструкций | (v5e/v5p) | (v6e/v7x) |
|---|---|---|
Векторная математика ( tanh , exp и т. д.) | 2 | 1 |
Флаг Миграция и примирение
В более ранних версиях документации XLA и TPU упоминался устаревший флаг --xla_enable_custom_call_region_trace=true .
- Канонический флаг :
--xla_xprof_enable_custom_call_tracing(каноническое имя, если требуются временные интервалы между пакетами инструкций во время выполнения; по умолчанию используйте только--xla_xprof_register_llo_debug_info=true). При включении активируется пользовательская трассировка вызовов, при этом автоматически настраиваются необходимые параметры инструментирования пакета инструкций и частоты трассировки (xla_tpu_bundle_instrumentation_options). - Устаревший флаг :
--xla_enable_custom_call_region_trace=true(устаревший псевдоним). Хотя он по-прежнему поддерживается более старыми бэкендами компиляторов, пользователям, которым необходимы временные интервалы пакетов во время выполнения, следует перейти на--xla_xprof_enable_custom_call_tracing.
Пример захвата данных по умолчанию (регистрирует отладочную информацию LLO, сохраняя при этом статистику HLO и ядра):
export LIBTPU_INIT_ARGS="--xla_xprof_register_llo_debug_info=true"
python your_jax_workload.py
Если включена трассировка пользовательских вызовов вместе с отладочной информацией LLO, в окне просмотра трассировки для каждого ядра TPU или устройства, выполняющего пользовательский вызов, появится новая строка, описывающая использование LLO .
Линия использования LLO
Линия использования LLO предоставляет визуализацию того, как используются аппаратные ресурсы во время выполнения пользовательского вызова. Это особенно полезно для выявления узких мест в пользовательских ядрах (например, написанных на Pallas или Mosaic).

Передовые методы и типичные ошибки на практике
- Используйте
xprof-nightly: в стандартной версииxprof2.23.1 отсутствуют подкомандыget_kernel_statsи LLO CLI (а также автономный скрипт консолиxparityдля проверки числовой четности). В средах, отличных от Google3, всегда устанавливайтеxprof-nightly. - Интерпретация метрик для ядер Pallas (слепая зона Roofline) : XLA не имеет модели стоимости для
tpu_custom_call. Поэтомуget_roofline_modelиget_overviewбудут сообщать0.0 GFLOP/s,"bound_by": "Unknown"и0.0%использования MXU, даже если инструкции LLO полностью захвачены и выполняются на оборудовании.- Для получения информации о длительности и задержке работы ядра используйте
xprof get_kernel_stats <logdir>. - Для анализа выполнения инструкций на низком уровне и оценки количества циклов используйте
xprof get_llo_analysis <logdir>.
- Для получения информации о длительности и задержке работы ядра используйте
- Внутренние тела циклов Lite Proto : В функции
get_llo_debug_stringвнутренние тела циклов суммируются следующим образом:// Loop body not available in lite proto. Оно предоставляет структуру окружающего модуля, распределение регистров и последовательность внешних инструкций. - Эвристический метод проверки трассировки : не проверять имена строк трассировки, такие как
SALU / VALU / EUP / XLU / VLD / VST / MXU Instructionsдля определения наличия данных LLO. Действительные трассировки LLO не используют эти имена строк. Проверьте захват LLO, выполнив командуxprof get_llo_analysis <logdir>и убедившись, что"success": true. - Размер ядра захвата : Слишком большой размер тестовых/захватывающих ядер может вызвать ошибки компилятора, такие как
CompileTimeScopedVmemOom: Scoped allocation with size 32.81M and limit 32.00M exceeded scoped vmem limit. Keep capture matrices notable size (eg(512, 512, 1024)f32). - Раздельные виртуальные среды : При портировании ядер между версиями JAX (например, устаревшие функции JAX 0.11+, такие как
pltpu.repeat) используйте выделенные виртуальные среды.